Agents IA : voir le travail derrière les statuts
Quand plusieurs agents se partagent une mission, je veux voir leur contexte, le travail produit et sa preuve. Mon essai local montre pourquoi les statuts ne suffisent pas.
Jean Willame · 27 septembre 2026 · 6 min
Sur Blueprint + Implement, j’ai déjà fait travailler quatre agents en parallèle. Ils se coordonnaient avec un simple fichier Markdown partagé. Je pouvais inspecter cette coordination sans ajouter une infrastructure de supervision.
Quand plusieurs agents se partagent une mission, je veux savoir pourquoi chacun fait sa tâche, quel contexte il utilise et ce que l’équipe a réellement livré. Un message envoyé ou une tâche marquée comme terminée me renseigne sur la coordination. Il me faut encore regarder le travail.
La présentation d’OpenRig a remis ces questions au premier plan. J’ai ensuite lancé un pilote local avec Codex et Claude Code pour voir ce qui était réellement observable quand les agents se coordonnent.
Quatre repères pour suivre le travail
La demande initiale. Je dois pouvoir la retrouver depuis la tâche en cours. Si un agent ajoute une étape, je veux comprendre ce qu’elle apporte à la mission. Une tâche peut être bien exécutée et élargir le périmètre sans raison.
Le contexte utilisé. Quel agent a reçu les règles, les fichiers et les décisions dont il avait besoin ? Et peut-on voir ce qu’il a effectivement consulté ? Déposer un document à sa disposition ne suffit pas à établir qu’il s’en est servi.
Le travail produit. Je veux regarder le fichier, le rapport ou la décision qui a changé. Le nombre de messages, de handoffs et de tâches closes est utile pour se repérer, mais ne raconte pas à lui seul ce qui a été construit.
La vérification. Avant de considérer le travail comme terminé, je veux retrouver les critères de départ et une façon de contrôler le résultat. Pour un rapport calculé à partir d’un CSV, cela peut vouloir dire reprendre les données et refaire le calcul séparément.
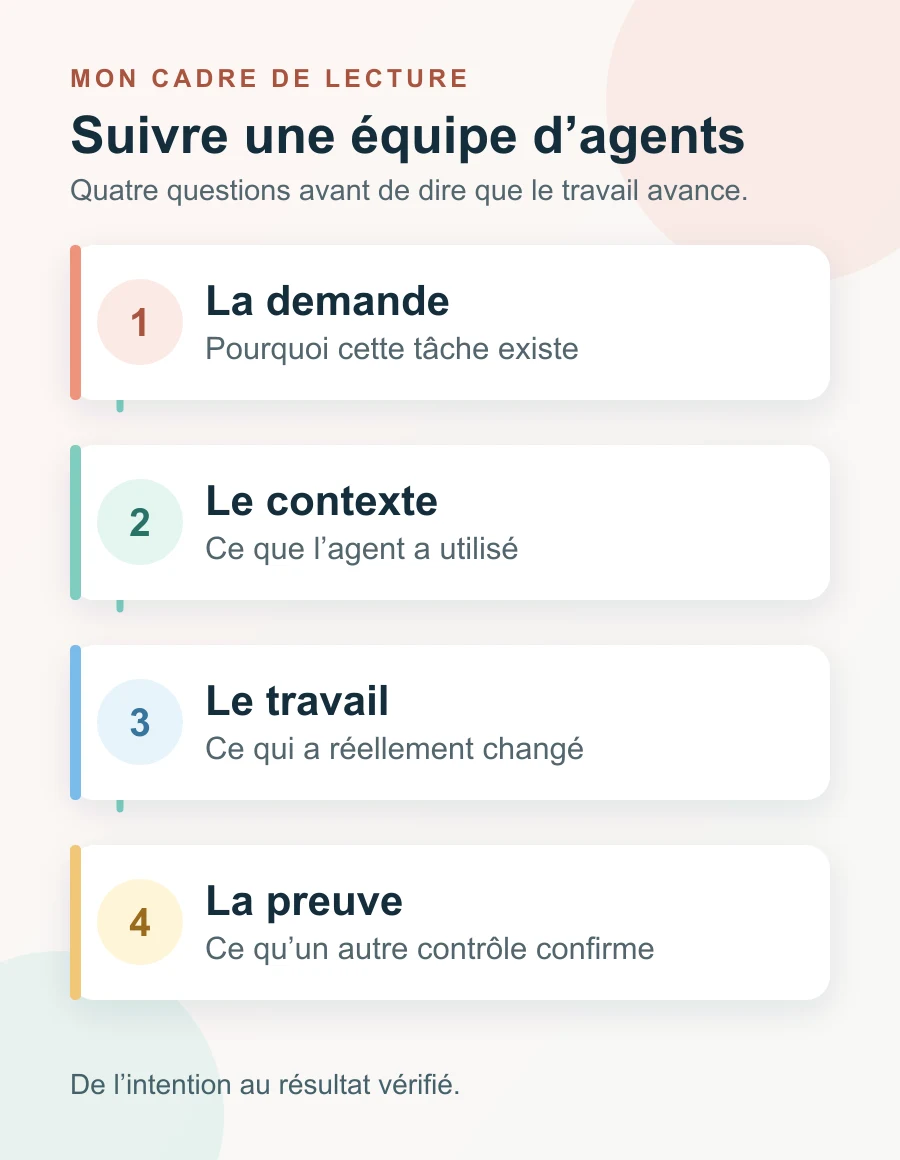
Les quatre questions que je veux pouvoir poser en regardant une mission, sans ouvrir chaque conversation.
J’avais déjà rencontré la question du contexte avec Doc-MCP. J’ai construit cet outil pour donner à Claude Code des extraits de documentation liés à la bonne version, au lieu de lui fournir des dizaines de pages d’un coup. Anthropic recommande aussi de sélectionner le contexte utile et de permettre à l’agent de récupérer les informations dont il a besoin au fil du travail.
Le volume de contexte ne garantit pas son usage. Dans Lost in the Middle, des chercheurs montrent que la position d’une information dans un long contexte peut dégrader sa récupération par un modèle. Leur étude porte sur des tâches de recherche d’information, pas sur mon équipe d’agents. Elle explique pourquoi je veux voir ce que l’agent a consulté, au lieu de supposer qu’un document disponible a été utilisé.
OpenRig propose de relier l’intention du projet aux unités de travail et à leurs preuves. Cette structure peut aider à garder le fil. Elle ne dispense pas de regarder ce qui s’est réellement passé dans la session de l’agent.
Éviter que la coordination prenne toute la place
Dans la vidéo d’OpenRig, une demande de niche pour un chien finit en projet de base lunaire : chaque ajout semblait utile depuis la tâche en cours. L’auteur montre aussi des agents qui ajoutent des contrôles après une erreur, puis des contrôles sur ces contrôles. Je me pose la même question pour mon propre système : comment rester informé sans construire une machine de supervision plus lourde que le travail lui-même ?
Ce risque existe au-delà d’OpenRig. Dans Building effective agents, Anthropic conseille de commencer par la solution la plus simple et de n’ajouter de la complexité que lorsqu’elle améliore le travail. C’est proche de ce que j’ai cherché avec le fichier partagé de Blueprint + Implement : une coordination lisible, proportionnée au problème.
Je veux assez de visibilité pour repérer une dérive et intervenir. Par exemple, voir qu’une tâche n’a plus de lien clair avec la demande, ou qu’une équipe échange beaucoup sans livrable nouveau. Un statut supplémentaire ne m’aide que s’il éclaire une décision à prendre.
Le bon niveau de contrôle dépend aussi de ce qu’on confie aux agents. Une réponse exploratoire et un résultat qui alimentera un processus métier n’appellent pas la même vérification. Je préfère partir des décisions que je devrai prendre en regardant le système, puis ajouter seulement les signaux qui m’aident à les prendre.
Ce que mon premier pilote a montré
J’ai testé OpenRig sur un scénario local avec des données fictives. Codex corrigeait un rapport issu d’un CSV. Claude Code relisait les règles et les données d’origine pour contrôler le résultat indépendamment. J’ai également arrêté puis relancé les sessions. Sur ce scénario guidé, les agents ont repris leur travail et un recalcul séparé a confirmé le rapport.
L’essai a aussi montré la limite d’un statut. Après un démarrage raté, un message a été signalé comme livré alors que l’agent était revenu au shell : le texte avait été collé dans ce shell. Dans une autre séquence de démarrage, un message envoyé à Claude n’apparaissait pas dans son historique visible.
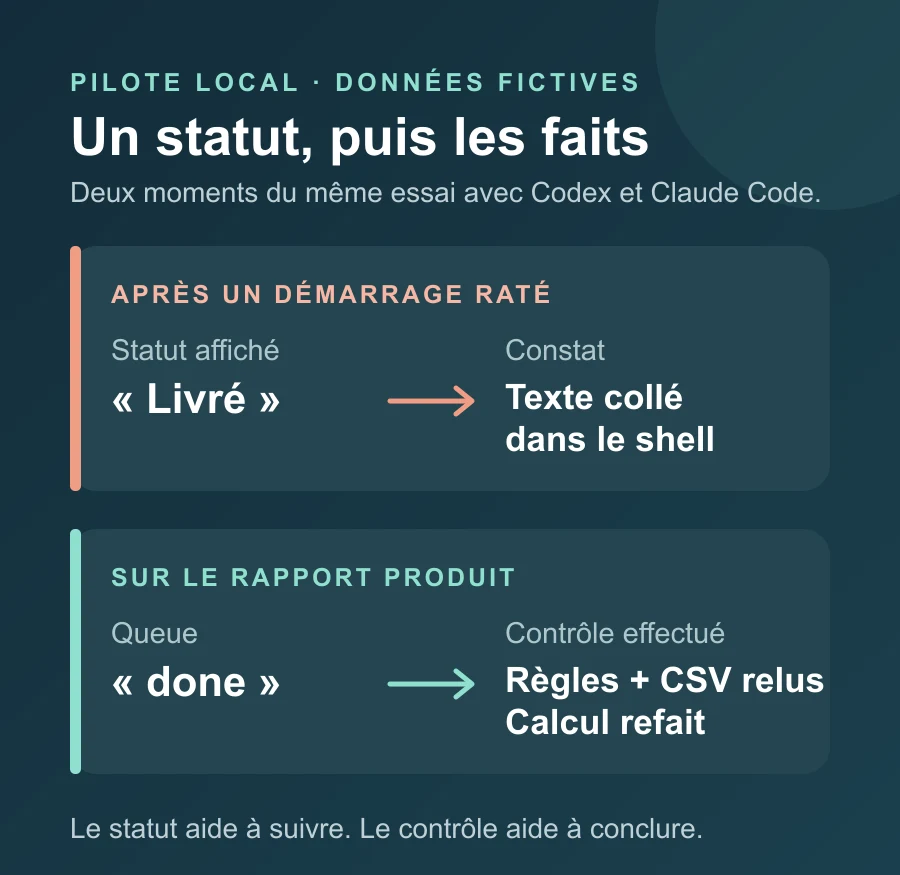
Dans le pilote, « livré » décrivait l’envoi. Le contrôle du rapport reposait sur les données d’origine et un recalcul séparé.
Ce contraste m’importe plus que le nombre de tâches clôturées. Quand un agent dit qu’il a fini, je veux pouvoir voir sa réponse dans la bonne session, lire le livrable et vérifier les points qui comptent. Le pilote montre que cette chaîne peut fonctionner sur un cas synthétique précis. Il ne prouve pas qu’une équipe autonome sera fiable sur un projet client.
Une prépublication sur les défaillances des systèmes multi-agents distingue, dans les traces qu’elle analyse, les problèmes de conception, les décalages entre agents et la vérification des tâches. Elle ne porte pas sur OpenRig ni sur mon pilote. Elle aide à nommer la distinction que j’ai observée : une équipe peut coordonner une tâche et encore avoir besoin d’un contrôle du résultat.
Ce que je veux encore vérifier
Je veux maintenant observer la continuité sur des tâches plus longues : ce que chaque agent retrouve après une reprise, le contexte qu’il utilise réellement et les moments où le travail s’écarte de l’intention initiale. Je veux aussi savoir si je peux voir ces écarts assez tôt, sans passer mes journées à surveiller des messages.
C’est le critère que je retiens pour mes projets d’agents IA en entreprise : pouvoir remonter du résultat à la demande et aux éléments qui le justifient. Une plateforme peut aider à organiser cette circulation. Je la jugerai sur ce qu’elle me permet de vérifier dans le travail produit.
Questions fréquentes
Comment savoir si plusieurs agents IA ont réellement terminé leur travail ?
Je repars de la demande, j’examine le livrable et je vérifie les points qui comptent à partir des sources d’origine. Un statut de coordination ne remplace pas ce contrôle.
Faut-il une plateforme pour coordonner plusieurs agents IA ?
Pas toujours. Pour Blueprint + Implement, un fichier Markdown partagé a suffi à coordonner quatre agents. Une plateforme devient intéressante si elle rend le contexte, la continuité et la vérification plus visibles.
Sources vérifiées
Diagnostics associés
Comment automatiser les relances clients sans perdre de leads en 2026 ?
Découvrez comment automatiser vos relances clients et devis en 2026 sans perdre de leads. Séquences CRM, workflows No-Code et agents IA pour booster vos ventes.
26 août 2026 · 7 min
Comment éviter les erreurs de saisie en entreprise en 2026 ?
Découvrez comment éliminer jusqu'à 90 % des erreurs de saisie manuelle en PME grâce à la validation à la source, l'automatisation par API et l'intelligence artificielle.
4 août 2026 · 6 min